
这条线在华东一家方形铝壳电芯厂的中试车间,日产十二万只,检测段四个工位:上料、六面外观、极柱检测、复判。十二台相机,2D与3D混用,来料只有一家供应商、两个型号。项目目标写得克制:综合误判率不高于百分之二,节拍不降。上海科迎法电气参与了光源与取图部分的改造,下面按时间顺序复盘三个月,重点写哪些条件撑住了结果,哪些条件换一家厂就不成立。立项时算过一笔账:误判率每降一个百分点,一年少报废约四十万元,少占用复判人力两人。
一、项目背景:一条刚投产的中试线
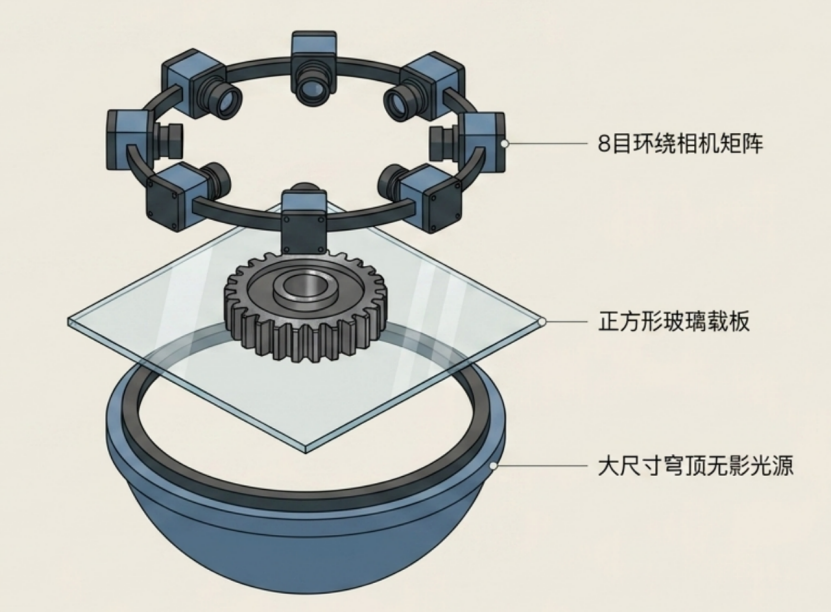
这类产线用的是电芯外观检测设备常见的多角度光源加多相机结构,六个面在一个节拍内取完图,任何一面成像不稳,整只电芯都要进复判。投产时的配置不算差:两千万像素相机、四路光源、三班运转,节拍九十件每分钟。问题出在稳定性,而不是分辨率。线体是直线式布局,工位之间用皮带衔接,震动通过支架传到相机,曝光瞬间的微抖在高倍率下同样会把边缘糊掉。
来料状态也影响成像。方形铝壳表面有拉丝纹路,不同供应商的纹路深度不同,反光方向跟着变;封边褶皱的深浅与注液孔周边的污渍,在固定角度下时隐时现。中试线的产品还在改版,壳体倒角与极柱高度三个月内调过两次,检测参数跟着改,没人做过系统记录。
二、问题数据:误判率8%不是均匀分布的
投产第一个月,综合误判率百分之八,其中过杀七点三、漏检零点七。只看总数会得出算法不行的结论;把数据按缺陷类型、班次、来料批次三个维度拆开,分布完全不是均匀的。壳体表面反光类误判占六成二,封边褶皱占一成八,极柱污渍占不到一成,其余杂项分摊。
班次差异同样明显:夜班比白班高一点八个百分点,同一批来料、同一套参数,差别只在环境光与人员状态。来料批次差异更大,某供应商的壳体拉丝更深,反光更碎,过杀率是另一家的两倍多。复判区按每班六人配置,每天约九千六百只电芯进复判,人均一小时判两百多只,眼睛很快疲劳,复判本身也开始出错。
还有一个容易被忽略的数字:设备自报的检出率是百分之九十九点六,看上去很好。可它的分母是设备报出的坏品数,漏掉的坏品根本不在里面。用人工全检对照三天,真实漏检是零点七,虽然不高,但足以说明报告口径与现场感受不是一回事。
误判的代价要分开算。过杀一只,损失的是复判工时与拆解风险;漏检一只流入下道,可能整组返工。按当时的返修单价,每天九千六百只复判对应六个复判工位与两条返修线,月度直接成本超过二十万元。这个数字放在项目会上,比任何百分比都有说服力。
三、诊断过程:先证明不是算法
第一周只做一件事:分层统计,不动任何参数。把每只误判电芯的图像、判定分数、工位、班次、批次拉成一张表,找出误判集中的位置。第二周做重复性试验:同一只电芯在同一工位连测十次,判定不一致率百分之三点一。这个数字说明问题不在阈值,而在成像,因为图像稳定时十次判定最多差一两次。
顺着成像查,找到三处。其一,暗场光源角度固定,来料反光方向一变,缺陷就被反光盖住;其二,频闪与相机曝光不同步,曝光时间波动,图像整体亮度忽高忽低;其三,遮光罩只挡了正面,夜班顶灯从侧面漏进来。第三周做对照试验:关掉一路侧光,过杀降了两个点,漏检升了一个点,证明光源是主因,但单纯减光会把缺陷一起减掉。
四个工位的判定分数分布也不一样:极柱工位整体偏高,外观工位整体偏低,同一个阈值在两个工位上的含义完全不同。此前为了省事,四个工位共用一套阈值,等于让四个裁判用同一把尺子量不同的东西。这一条解释了不少莫名其妙的分歧,也为后面的分层判定埋下依据。
算法侧也不是没有问题。原模型训练时把反光当成了缺陷特征,样本里这类图太多,模型学会了亮斑即缺陷。这套深度学习视觉检测系统本身支持分组训练与置信度输出,但当时只用了一个大模型、一个阈值,所有缺陷类型挤在一起,互相迁就。诊断结论写成三条:成像不稳、样本偏斜、判定不分层。
四、三项措施:光源、样本、判定
措施一,光源改造。四路光独立可调:同轴光压表面反光,低角度暗场抓划痕,背光看封边轮廓,侧光补极柱。频闪由相机触发,曝光与闪光同一时基;遮光罩改成半封闭,顶部与侧面都挡。取图角度从固定两角度改成按缺陷类型分组,每组三到四个角度,借鉴注射器视觉检测机旋转工位多次取图的做法,让同一处缺陷在不同照明下暴露两次。改造后先做光源均匀性验收:铺一张白板,九个点灰度差控制在百分之五以内;再用标准样品跑一百次,确认同一缺陷在四个角度下至少有三个能被稳定拍到。参数写进配方,换型时按配方调用,不靠调机师傅的记忆。
措施二,样本回流。每天把复判确认的误判图入库,周三做一次标注复核,每月训练一版。边界样本由工艺、质量、设备三人分别标注,不一致的单独封存,不参与训练。训练集与验收集按来料批次切分,避免同一批样本既教又考。反光与褶皱各建子集,子集内再按严重度分级,模型输出不再是一个笼统的坏品概率。标注规范写成图文对照:反光不算缺陷、褶皱按长度分三级、污渍按面积分两级,争议样本单独编号。这样做的直接好处是训练标签稳定,模型不会今天学一个标准、明天学另一个。
措施三,判定分层。设双阈值:高置信度直接剔除,低置信度进复判,中间带不再一刀切。极柱高度、平面度这类必须给数的项目,从2D判定改为3D线激光轮廓设备测量,2D只负责表面纹理。复判结果当天回写,谁的判定被改,第二天就能在报表里看到。三项措施没有同时上,按光源、样本、判定的顺序,每项跑两周再叠加,才能看出各自贡献。
五、结果数据:误判率从8%到1.2%的曲线
第四周综合误判降到五点六,第六周三点四,第八周一点九,第十二周一点二,其中过杀零点九、漏检零点三。复判人员从每班六人降到两人,节拍保持九十件每分钟,没有换相机,没有加算力。第十周换了一个来料批次,误判反弹到三点五,两周后回落到一点五,说明模型对批次差异仍有滞后,样本回流不能停。连续三周的抽检数据也稳定:第一周一点三、第二周一点一、第三周一点二,没有大起大落。设备综合效率从百分之七十八升到八十六,主要来自复判拥堵的缓解。光源与相机的维护周期也改了,光学件按粉尘浓度每两周清一次,频闪电源每季度测一次波形。
投入产出也算得清:光源改造与遮光罩约十一万元,标注与训练工时折算约四万元,每月节省复判工时与报废损失约三万元,回收期五个月出头。这个账只算了直接成本,没算误判带来的交付延误;若把一次客诉的处置成本计入,回收期更短。
六、可复制与不可复制
可复制的部分:先分层再调参,不靠拍脑袋改阈值;用重复性试验区分成像问题与算法问题;双阈值把复判变成资源而不是补丁;样本按批次切分;光源按缺陷类型分组。这五条与产品无关,换一条线也能用。尤其第一条,很多项目一上来就换模型,换完才发现图像本身在抖。
不可复制的部分也要说清楚。这家厂来料只有一家供应商、两个型号,样本相对干净;有三名专职标注人员,能保证每周复核;中试线允许每周停线两小时做对比试验;缺陷类型不到二十种。多品种小批量、来料杂、没有标注团队的厂,照搬每月训练一版的节奏,只会把模型带偏。先把样本库建起来,再谈迭代频率。还有一条隐性条件:这家厂的质量部愿意把复判结果每天导回设备,数据不断流;不少厂复判记录留在纸上,样本回流从第一天就断了。
还有一条隐性条件:管理层接受了先降过杀、再降漏检的顺序。前期关掉一路侧光时,漏检短暂上升,如果没有这个共识,项目在第三周就会被叫停。复盘的价值不在八个百分点的降幅,而在把这条路径写下来,让下一条线少走三个月。需要按缺陷类型配置光源与工位的项目,可以在视觉检测设备目录里对照各机型的取图方式。科迎法电气建议,先做两周数据分层,再决定要不要动硬件。


